Успехът на един сайт до последните няколко години се определя от солиден трафик и високи позиции в страницата с резултати от търсачките (SERP).
Поради появата на Google AI Overviews, ChatGPT, Claude и Perplexity, потребителите все по-често взаимодействат с резултати, задвижвани от изкуствен интелект, които обобщават, анализират и отговарят директно на заявки. Екипите се борят с ефектите от търсенията с нулево кликване, при които потребителите намират отговор, без дори да кликнат върху връзка. Според последните данни от индустрията, AI може да намали процента на кликване за информационни заявки с близо 60%, защото отговорът се сервира на сребърен поднос, преди потребителят дори да се наложи да скролва. Това променя естеството на онлайн видимостта.
Търсачката с изкуствен интелект е всяка система за извличане на информация, която синтезира информация от мрежата в директен, разговорен отговор, вместо да предоставя списък със съответните връзки. Докато традиционните търсачки съпоставят ключови думи и оценяват авторитета, за да класират страниците, търсачките с изкуствен интелект използват тези страници като сурови данни, за да изградят последователен наративен отговор за потребителя.
В основата на тези системи са моделите на големи езици (LLM). Това са модели, обучени върху огромни набори от данни, за да разберат нюансите на човешкия език. Тези системи обаче събират данни само до определен момент във времето. Това е известно като прекъсване на знанията: моментът, след който LLM не е обучен на нови данни. Генерирането с добавено търсене (RAG) е процес, който заобикаля прекъсването на знанията, позволявайки на системите с изкуствен интелект да разглеждат активната мрежа, да извличат най-подходящата информация и да използват езиковите си възможности, за да обобщят отговора.
Въпреки впечатлението, че тези инструменти са дошли директно от научнофантастичен филм, те не са точно от друг свят. Те просто разчитат до голяма степен на висококачествено уеб съдържание и структурирани данни. Търсенето с изкуствен интелект променя начина, по който потребителите взаимодействат с информация онлайн, но екосистемата за търсене все още зависи от технически издържани и авторитетни уебсайтове, които да предоставят истината за тези инструменти.
В търсенето с изкуствен интелект, класирането е процесът на избиране на най-точните и полезни „парчета“ информация, за да се отговори на въпроса на потребителя. Вместо просто да изброява десет сини връзки, изкуственият интелект избира конкретни изречения или параграфи от различни уебсайтове, за да изгради единен, унифициран отговор.
Дали търсачките с изкуствен интелект класират уебсайтове?
Да, търсачките с изкуствен интелект класират уебсайтове, но го правят, като оценяват отделни части информация, а не само цялата страница. Когато изкуствен интелект получи заявка, той търси в индекса си най-подходящите данни и присвоява оценка на различни източници въз основа на това колко добре отговарят на конкретния въпрос.
Докато традиционната търсачка може да класира целия ви URL адрес на трета позиция, търсачката с изкуствен интелект може да „класира“ само втория ви параграф като най-добър отговор на конкретен въпрос. Това означава, че видимостта ви зависи от това колко ясно обяснявате конкретни точки. Ако съдържанието ви е неясно, изкуственият интелект ще ви пропусне и ще премине към конкурент, който предоставя директен, лесен за разбиране отговор.
По какво се различава класирането с изкуствен интелект от резултатите от търсенето в Google?
Класирането с изкуствен интелект се фокусира върху оценката на релевантността и директните отговори, докато традиционните SERP (страници с резултати от търсачките) на Google се фокусират върху сигнали на ниво страница, като обратни връзки и метаданни. При традиционното търсене целта е да накарате потребителя да кликне върху връзката ви; при търсене с изкуствен интелект целта е да бъдете източникът, на който изкуствен интелект се доверява, за да генерира отговора си.
Традиционното SEO разчита до голяма степен на „авторитета“ на целия домейн. За разлика от това, генеративното класиране в търсенето е по-скоро за това колко добре определен раздел от вашата страница се вписва в „мисловния процес“ на изкуствения интелект. Може да имате сайт с нисък авторитет, но ако имате най-ясното обяснение на нишова тема, изкуственият интелект е по-вероятно да ви цитира, отколкото масивен сайт с обща информация.
Какво е chunk-level ranking?
Chunk-level ranking е методът, при който изкуственият интелект разделя дълга статия на по-малки секции (парчета), за да види коя конкретна част решава проблема на потребителя. Вместо да разглежда публикацията ви от 2000 думи като едно цяло, изкуственият интелект я вижда като пет или шест отделни блока информация.
Ето защо форматирането е толкова важно сега. Ако вашите „парчета“ са разхвърляни или обхващат твърде много теми едновременно, изкуственият интелект не може да ги разбере. Като използвате ясни заглавия и се придържате към темата във всеки параграф, вие помагате на изкуствения интелект да индексира съдържанието ви по-ефективно. Това е основна промяна в начина, по който алгоритмите на изкуствения интелект класират уебсайтове.
Докато традиционното SEO се фокусира върху сигнали, които удовлетворяват робота, генеративната оптимизация за двигатели (GEO) се фокусира върху сигнали, които удовлетворяват нуждата на модела на изкуствен интелект от точност, за да определи стойността на цитиране. Изкуственият интелект по същество търси най-добрите доказателства в подкрепа на добре конструиран отговор. Тази подкрепа се определя от няколко основни фактора.
Семантиката е важна за системите с изкуствен интелект. Можете да споменавате конкретна ключова дума колкото искате, но изкуственият интелект търси връзки между термините или „обектите“, споменати в сайта, за да определи тематичния авторитет.
Наличието на различни части от съдържанието, които обхващат всеки аспект на дадена тема в дълбочина, сигнализира на изкуствения интелект, че вашият сайт показва авторитет по тази тема.
Изследване относно поведението при цитиране на LLM показва, че обемът на търсене на марка е силен предсказващ фактор за цитиране на LLM, с корелация от 0,334. Това надвишава факторите за класиране, върху които маркетолозите традиционно се фокусират, като например обратните връзки. Накратко, моделите с изкуствен интелект предпочитат марки, които хората вече търсят.
Последователността в мрежата също е важна. Ако вашата марка е спомената като експертен източник в LinkedIn, Wikipedia и големи новинарски издания, това ще увеличи доверието на изкуствения интелект във вашето съдържание като цитируем източник.
Изкуственият интелект не може да цитира това, което не може да прочете. Технически основи като скорост на зареждане на страницата и чист код остават толкова важни, колкото винаги, но има допълнителен акцент върху извличаемостта на вашето съдържание.
Системите с изкуствен интелект предпочитат съдържание, което е ясно форматирано. Мислете за ясни заглавия, списъци с маркирани маркери, често задавани въпроси и ключови изводи. Ако даден модел може лесно да различи определение от сравнение в рамките на вашата кодова структура, е много по-вероятно да извлече този сегмент от вашето съдържание в генериран отговор.
ИИ търсачките използват обработка на естествен език (NLP), за да разберат „защо“-то зад дадено търсене. Те не търсят просто думите „най-добра пица“; те се опитват да разберат дали искате рецепта, ресторант наблизо или историята на ястието.
Как ИИ интерпретира намерението на потребителя?
ИИ интерпретира намерението на потребителя, като анализира контекста и връзката между думите в заявката, за да определи основната цел на потребителя. Той надхвърля простото съвпадение на ключови думи, за да разбере „семантиката“ или действителното значение на това, което се пита.
Какво представляват вгражданията в търсенето с ИИ?
Вгражданията са математически представяния на думи и изречения, които позволяват на изкуствения интелект да разбере как различните понятия са свързани. Чрез превръщането на текста в числа (вектори), изкуственият интелект може да „види“, че „куче“ и „куче“ са почти едно и също нещо, дори ако думите изглеждат различно.
Когато пишете съдържание, изкуственият интелект създава вграждания за вашия текст. Ако тези числа съвпадат с числата, генерирани от заявката за търсене на потребителя, вие се класирате по-високо. Ето защо използването на естествен, описателен език е по-добро от повтарянето на една и съща ключова дума отново и отново.
Какво е вграждане на заявки?
Вграждането на заявки е процесът на превръщане на въпроса за търсене на потребителя в числов вектор, така че изкуственият интелект да може да го сравни със своята база данни. Това позволява на системата да намира отговори, които дори не съдържат точните думи, използвани в търсенето.
Какво е оценяване на семантичното сходство?
Оценяването на семантичното сходство е начинът, по който изкуственият интелект измерва разстоянието между въпроса на потребителя и вашето съдържание. Колкото по-близо е „значението“ на вашия текст до въпроса, толкова по-висока ще бъде вашата оценка за релевантност.
Начинът, по който изкуственият интелект намира вашето съдържание, е чрез процес, наречен извличане. Той не просто „знае“ всичко; той трябва да излезе и да вземе правилните данни от масивен индекс.
Какво е генериране с добавено извличане (RAG)?
Генерирането с добавено извличане (RAG) е рамка, при която изкуственият интелект извлича прясна информация от интернет, за да отговори на заявка, вместо да разчита само на предварително обучената си памет. Това гарантира, че предоставените отговори са актуални и обосновани с факти.
RAG е причината, поради която новата ви публикация в блога може да се появи в отговор на ChatGPT или Gemini днес. Изкуственият интелект „извлича“ вашето съдържание, чете го и след това „генерира“ резюме. За да се класира добре тук, вашето съдържание трябва да е лесно за бързо извличане и разбиране от изкуствения интелект.
Как изкуственият интелект избира документи, преди да отговори?
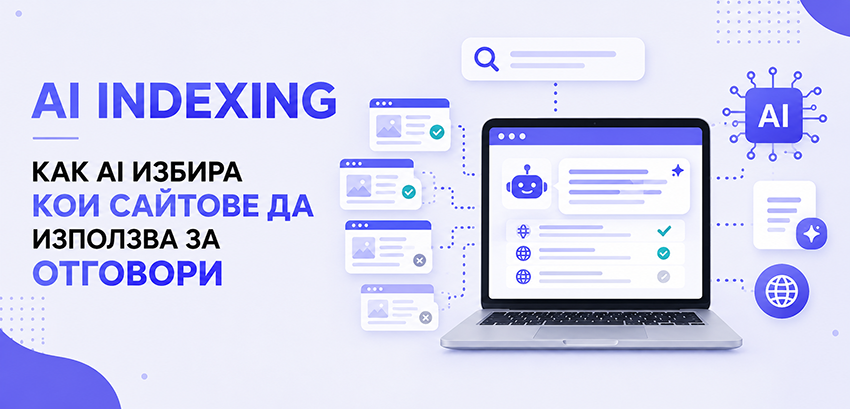
Изкуственият интелект избира документи, като филтрира милиони страници, за да намери малък „пул“ от кандидати, които имат най-висок резултат за релевантност. След като има кратък списък от около 10 до 50 източника, той ги разглежда по-внимателно, за да избере най-добрите за окончателния отговор.
Този процес на подбор се случва за милисекунди. Изкуственият интелект търси сигнали за доверие, като ясно авторство, фактически данни и техническа точност. Ако вашата страница е избрана за този „кратък списък“, имате голям шанс да бъдете сред финалните цитати.
Каква роля играе векторното търсене?
Векторното търсене позволява на изкуствения интелект да намери вашето съдържание въз основа на концепции, а не само на съвпадащи символи. То използва споменатите по-рано вграждания, за да търси в граф от знания на свързани идеи.
Мислете за векторното търсене като за библиотека, организирана по „вибрации“ и „теми“, а не само по азбучен ред. Ако съдържанието ви е заровено в PDF файл или в разхвърляно оформление, векторното търсене може да се затрудни да го индексира. Чистият, структуриран текст е победителят тук.
Основните фактори за класиране в търсенето с изкуствен интелект са специфичните сигнали, използвани от генеративните двигатели, за да определят кое съдържание е най-точно, авторитетно и полезно за потребителя. През 2026 г. тези фактори се изместиха от просто съвпадение на ключови думи към сложна оценка на релевантността, E-E-A-T (Опит, Експертиза, Авторитетност и Достоверност) и „машинночетимост“.
Въпреки че ключовите думи все още имат значение, факторите, които движат иглата в търсенето с изкуствен интелект, са по-скоро за Авторитета и как вашите данни се свързват с по-широката мрежа.
Да, тематичният авторитет е основен фактор, защото моделите с изкуствен интелект предпочитат източници, които постоянно пишат по определена тема. Ако вашият сайт е експерт по „органично градинарство“, изкуственият интелект е по-вероятно да се довери на вашата „част“ за доматената мана, отколкото на общ новинарски сайт.
За да изградите това, трябва да създадете клъстер от свързани статии. Тази статия, например, е част от нашата поредица за видимостта в търсенето с изкуствен интелект. Като обхващате всеки ъгъл на дадена тема, вие показвате на графата на знанията на изкуствения интелект, че сте надежден източник.
Разпознаването на обекти помага на изкуствения интелект да идентифицира „съществителните“ във вашето съдържание и да ги свърже с глобална графа на знанията. Ако изкуственият интелект знае, че говорите за „Apple“ – компанията, а не за „ябълка“ – плода, той може да ви класира по-точно.
Обратните връзки все още имат значение, защото служат като сигнали за доверие, казвайки на изкуствения интелект, че други хора ценят вашата информация. Те обаче са по-малко за „сила“ и повече за „контекст“. Връзка от подходящ нишов сайт често струва повече в търсенето с изкуствен интелект, отколкото обща връзка от сайт с висок трафик.
Да, споменаванията на марки – дори без връзка – помагат на изкуствения интелект да разбере вашия авторитет. Когато вашата марка се споменава редом с конкретни теми в мрежата, изкуственият интелект започва да ви асоциира като експерт в тази област.
Доверието се оценява чрез търсене на цитати, проверени факти и последователна информация. Ако вашият сайт изброява факти, които противоречат на общото мнение, без основателна причина, изкуственият интелект може да маркира съдържанието ви като ненадеждно и да понижи класирането ви.
ИИ двигателите избират източниците да цитират, като оценяват статистическата вероятност, че определен „парче“ информация е най-точният, авторитетен и подходящ отговор на потребителското запитване. За разлика от традиционното търсене, което търси най-добрата страница, търсенето с ИИ използва разширено генериране на извличане (RAG), за да намери най-добрите изречения в множество сайтове.
Защо някои страници се цитират многократно?
Страниците се цитират многократно, защото предоставят уникални данни, ясни дефиниции или експертни мнения „от първа ръка“, които ИИ не може да намери другаде. ИИ обича „оригиналността“, защото тя добавя стойност към генерирания отговор.
Как работи оценката за доверие в цитирането?
Оценката за доверие е показател, който ИИ използва, за да реши дали вашата информация е безопасна за повторение. Ако множество сайтове с висок авторитет казват същото, което и вие, доверието на ИИ във вашето „парче“ се увеличава.
Разлика между цитиране и класиране?
Класирането се отнася до това къде се намирате в резултатите от търсенето, докато цитатът се използва като основен източник за писмения отговор на ИИ. Можете да се класирате в топ 10, но да не бъдете цитирани, ако съдържанието ви не е „подходящо за обобщение“.
Полезно е да ги видите едно до друго, за да разберете как да промените стратегията си.
Функция | Традиционно SEO | Класиране в търсенето с ИИ |
Фокус | Ключови думи и връзки | Обекти и значение |
Единица | Цяла уеб страница | Информация на „парчета“ |
Цел | Кликвания към сайта | Източник (Цитати) |
Структура | Дългоформатно съдържание | Модулна, стил с въпроси и отговори |
Сега, след като знаете как работи, ето как да поправите съдържанието си, за да спечели.
Използвайте структура „Заглавие -> Директен отговор -> Дълбоко потапяне“. Това гарантира, че изкуственият интелект намира отговора веднага под H2 или H3, което е точно това, което търси.
Бъдете конкретни. Използването на собствени имена помага на изкуствения интелект да съпостави съдържанието ви с правилната графа на знанията.
Вътрешните връзки казват на изкуствения интелект кои страници са свързани. Ако добавите линк от тази статия към нашата страница за AEO срещу GEO срещу SEO обяснение, това помага на изкуствения интелект да види „мрежата“ от знания, която изграждате.
Бъдещето на онлайн видимостта принадлежи на тези, които биват цитирани. Тъй като потребителите свикват със синтезираните отговори, стойността на това да бъдеш източник на истина за системите за търсене с изкуствен интелект ще се увеличи рязко. Вървим към свят, където споменаванията на марки и уеб присъствието са толкова ценни, колкото и традиционните SEO класации.
Данните показват, че припокриването на домейни между системите с изкуствен интелект е силно разнообразно. Някои системи имат до 42% припокриване в цитатите, докато други се припокриват едва с 11%. Ландшафтът е фрагментиран и видимостта в една система не гарантира цитиране в друга. Въпреки това, споменаването на марки в множество платформи може да увеличи вероятността за цитиране до 2,8 пъти в отговорите на ChatGPT. Така че е логично, че колкото повече сте цитирани сега, толкова повече ще продължите да бъдете цитирани и в бъдеще.